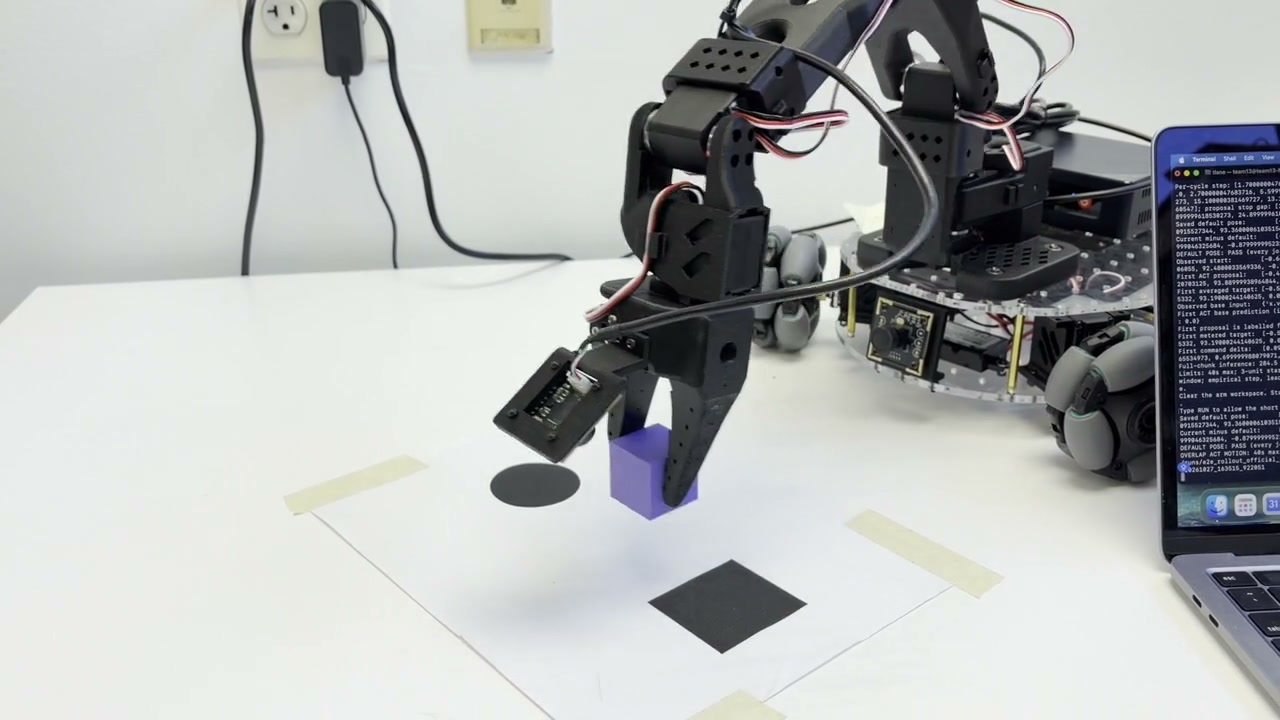
我做了什么
这个 task 非常简单:让机器人把一个方块抓起来,然后放到圆圈里。
我用的是 SO-101 leader-follower 低成本机械臂、一个装在手腕上的相机和 LeKiwi 底盘。先由我自己遥操作 leader arm 完成任务,采集 demonstrations;再通过 LeRobot 的官方 pipeline 训练 ACT;最后把 policy 部署到只有 CPU 的 NUC 上,让机器人自己完成 reaching、picking、transporting、placing 和 return。
听起来就是很经典的 imitation learning 流程:
人类示范
→ 收集 dataset
→ 训练 policy
→ 部署到机器人
→ 机器人学会了
但真的动手之后就会发现,最后那个“机器人学会了”里面,藏了特别多事情。
第一次采 demonstrations
这是我第一次真正为 robot learning 采 demonstrations。我一共采了大约 200 条,清洗后留下 158 个 episodes,其中 134 条用于训练,24 条用于 held-out review,最终选择了 18,000 steps 的 checkpoint。
这 158 条数据大概分成两部分:
- 前 110 条主要改变相机画面里的场景,但是动作基本沿着 happy path 走。
- 后 48 条保持场景稳定,故意在抓取和放置时 overshoot,然后再恢复。
回头看,这里的数据远远谈不上完美。尤其是 motion variation 和 recovery examples 还是太少了。模型偶尔确实表现出了恢复能力,但并不稳定。
这也是我第一次很直接地感受到:demonstration 不是“成功动作录得越多越好”,它实际上是在决定 policy 以后见过什么世界,又有能力从哪些错误里回来。
Offline 能跑,真机不一定听话
训练完成之后,held-out episode 上的预测看起来挺不错的。然后我兴冲冲地把 policy 放到真机上——机械臂开始摇、过冲,有时候还会直接触发 controller stop。
好嘛,真正的问题才刚刚开始。
NUC 上一次 ACT inference 的 median latency 大约是 321 ms,而 controller nominally 需要以 30 Hz 持续获得 command。模型还在想下一段 action 的时候,机器人不能原地卡住;但如果只是粗暴地把新旧 action chunk 接起来,target 又很容易发生突变。
所以最后我做了一套异步的执行链路:
- 后台 worker 根据最新 observation 推理一个 30-step action chunk。
- controller 在推理期间继续消费旧 queue 里的 command。
- 新 chunk 到达后,丢弃已经过期的 prediction。
- 对指向同一个 future cycle 的 overlapping actions 做 blending。
- 在 controller side 对前五个 arm channels 做 α filter,gripper 不参与滤波。
- 先检查 raw proposal,再检查 filtered target 和 measured state,越界就 stop。
简单来说就是:
让模型在后台继续想,让机器人用已经拿到的 action 保持运动;新的 prediction 回来之后,再把时间上真正对得上的部分接进去。
这套 scheduling 和 filtering 并没有让 inference latency 消失。它只是承认延迟真实存在,然后尽可能让 command flow 不要因为模型思考而断掉。
我怎么知道滤波到底有没有用?
肉眼觉得“好像顺了一点”肯定不够,所以我最后跑了 95 次独立真机 trials,每次最多 40 秒,测试了五组 α,同时也测试了底盘左右偏移 ±2 cm 和六种方块朝向。
α = 1.0 是不进行平滑的 baseline。不同 α 下的 placement 结果是:
| α | 成功放置 | 放置并返回 | Controller stops |
|---|---|---|---|
| 0.1 | 8/10 | 8/10 | 0/10 |
| 0.2 | 7/10 | 7/10 | 0/10 |
| 0.5 | 8/10 | 7/10 | 0/10 |
| 0.8 | 6/10 | 6/10 | 3/10 |
| 1.0 | 6/10 | 6/10 | 3/10 |
在我的这些测试里,更低的 α 确实让机械臂看起来更平滑,而且没有触发 controller stop。但每组只有十次,我不觉得这已经足以宣布某个 α 是“最优参数”。
另外,当我固定 α = 0.5,再去改变底盘位置和方块朝向时,执行效果还是会明显掉下来。也就是说,这个 policy 在原始 task 上已经能工作,但对 scene change 的 robustness 仍然很有限。
完整对比视频和实验图表可以在 Mickey17 Demo 里直接看。
这个项目真正让我学到的东西
我一开始理解的 imitation learning,多少还是 dataset → model → loss → deployment 这样一条很 ML 的链路。
真正把它放到机器人上之后,我发现一个 policy 能不能工作,其实是一个完整的 system problem:
- demonstration 有没有覆盖错误和恢复;
- camera 在关键时刻到底看不看得到方块和目标点;
- inference 做完时,这个 observation 还是不是“现在”;
- action chunk 在时间上怎么对齐;
- 新旧 prediction 怎么交接;
- command 怎么平滑,又怎么保证不会越过安全边界;
- 最后到底用什么 evidence 判断它是真的变好了,而不只是某一次刚好成功。
Offline prediction 只能说明模型在 recorded observation 上会输出什么,它不能替代真实世界里的 task success。对我来说,这个项目最有价值的地方也正在这里:我第一次把 predictions、sent commands、controller echo 和 measured motion 放到一起看,然后开始理解一个 learning policy 是怎么真正进入物理世界的。
还没解决的东西
Mickey17 现在仍然只是一个 side project。trial group 很小,labels 和 placement time 是我自己记录的,scene variation 也很有限。weights、demonstration videos 和完整 NUC environment 目前没有公开。
之后如果继续做,我觉得更值得补的是:
- 采更多 motion variation 和 recovery demonstrations;
- 做 image / demonstration augmentation;
- 尝试 Real-Time Chunking;
- 再去摸一摸 VLA policy。
不过这些是以后可能做的方向,不是我现在已经完成的东西。至少在这一次,我已经完整经历了从“我来教机器人做一次”,到“它在真实世界里自己做”,再到“失败之后我怎么知道问题究竟在哪里”的全过程。